Archivierung und Suche von Unternehmensdokumenten, mit Texterkennung aus Bildern und PDFs für die Volltextsuche.
Überblick
Ein System zur geordneten Ablage von Unternehmensdokumenten. Neben der Speicherung der Dateien wird der Text aus gescannten Dokumenten und PDFs extrahiert, sodass die Suche im echten Inhalt arbeitet und nicht nur im Dateinamen.
Ausgangslage
Dokumente lagen verstreut in Netzwerkordnern. Ein bestimmtes Dokument zu finden hing vom Gedächtnis einzelner Personen ab, und gescannte Dokumente waren überhaupt nicht durchsuchbar.
Lösung
Ein System, in dem jedes Dokument beim Hochladen kategorisiert und verschlagwortet wird. Bei Bildern und PDFs wird der Text per OCR erkannt und indexiert. Die Suche umfasst Titel, Schlagwörter und erkannten Text, und der Zugriff auf jede Kategorie richtet sich nach der Benutzerrolle.
So habe ich es gebaut
- 01
Jedes Dokument wird beim Hochladen kategorisiert und verschlagwortet. Bei Bildern und PDFs wird der Text per OCR erkannt und mit dem Dokument indexiert.
- 02
Die Suche arbeitet auf Titel, Schlagwörtern und erkanntem Text, und der Zugriff auf jede Kategorie wird über die Benutzerrolle gesteuert.
Funktionen
- Kategorisierte, verschlagwortete Ablage
- Texterkennung aus Bildern und PDFs (OCR)
- Volltextsuche im Dokumentinhalt
- Rollenbasierte Zugriffskontrolle
Ergebnis
Die Dokumente liegen in einem einheitlichen, durchsuchbaren Archiv, und das Finden hängt nicht mehr vom Gedächtnis Einzelner ab.
Technologien
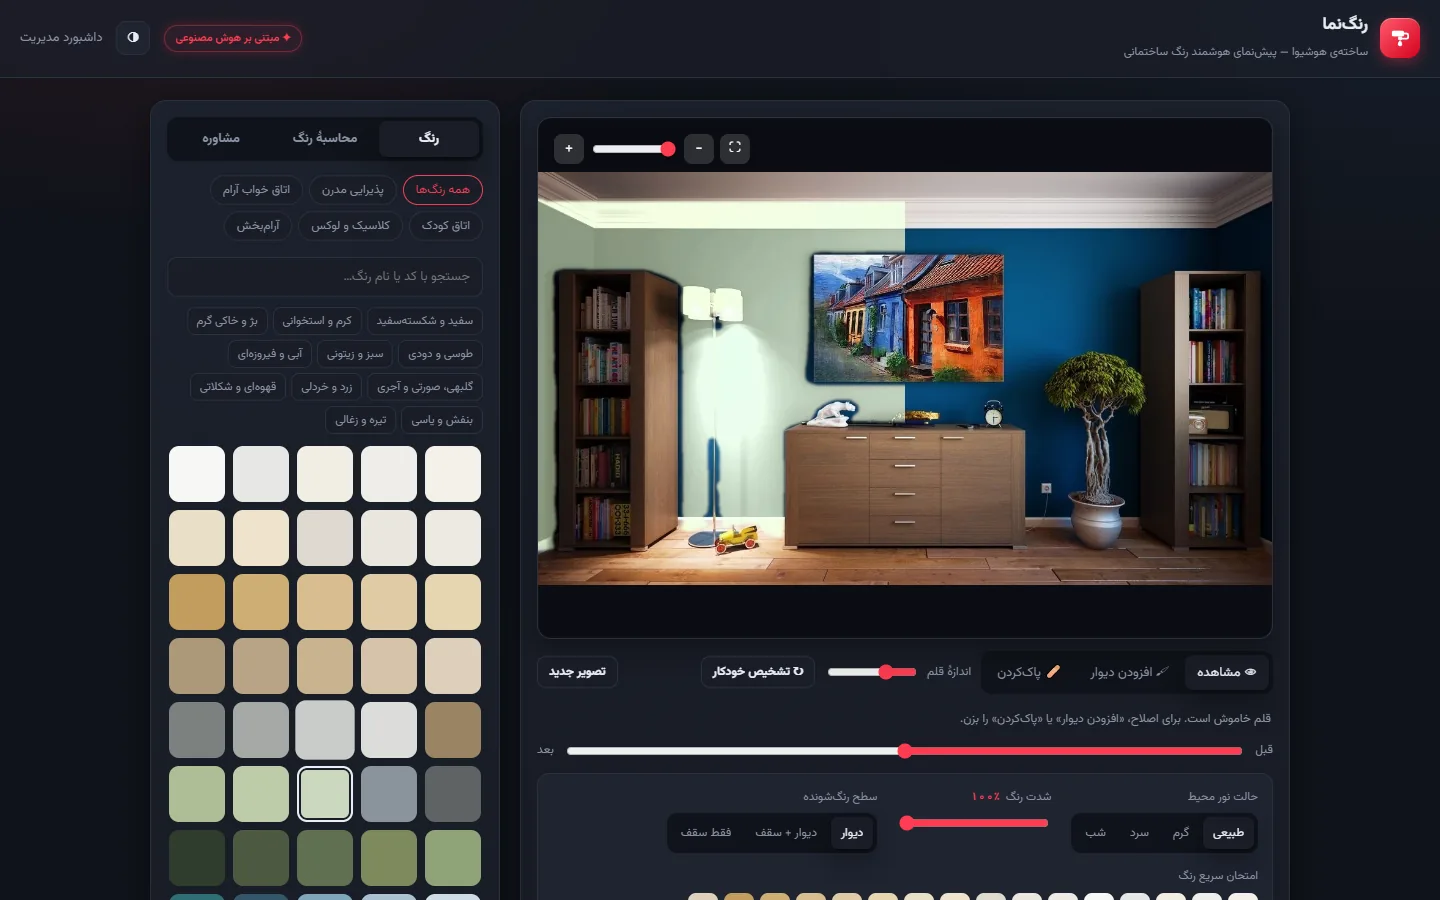
Rangnama: KI-Farbvorschau für Gebäude
Kunden laden ein Foto ihres Zimmers oder ihrer Fassade hoch. Die KI erkennt in wenigen Sekunden die Wände und färbt sie in der gewählten Farbe ein, wobei Licht, Schatten und Struktur des Fotos erhalten bleiben.
Projektdetails ansehen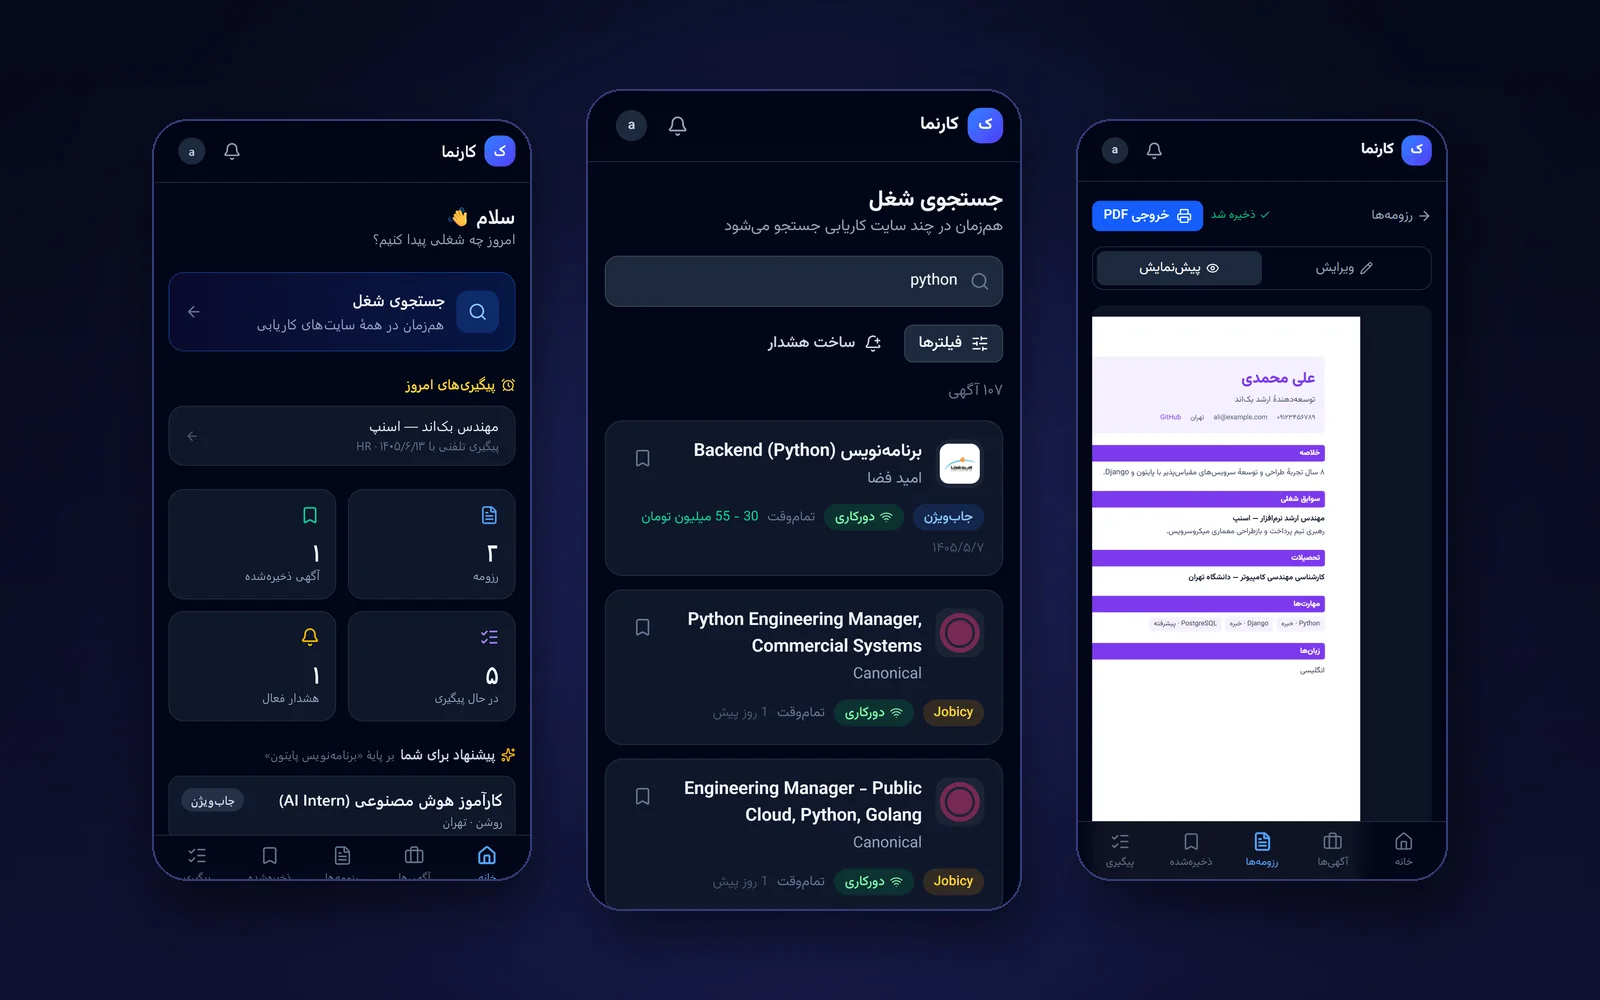
Karnama: smarte Jobsuche-App
Eine Mobile-first-App für Jobsuchende: mehrere Jobbörsen gleichzeitig durchsuchen, einen persischen Lebenslauf erstellen und Bewerbungen nachverfolgen.
Projektdetails ansehen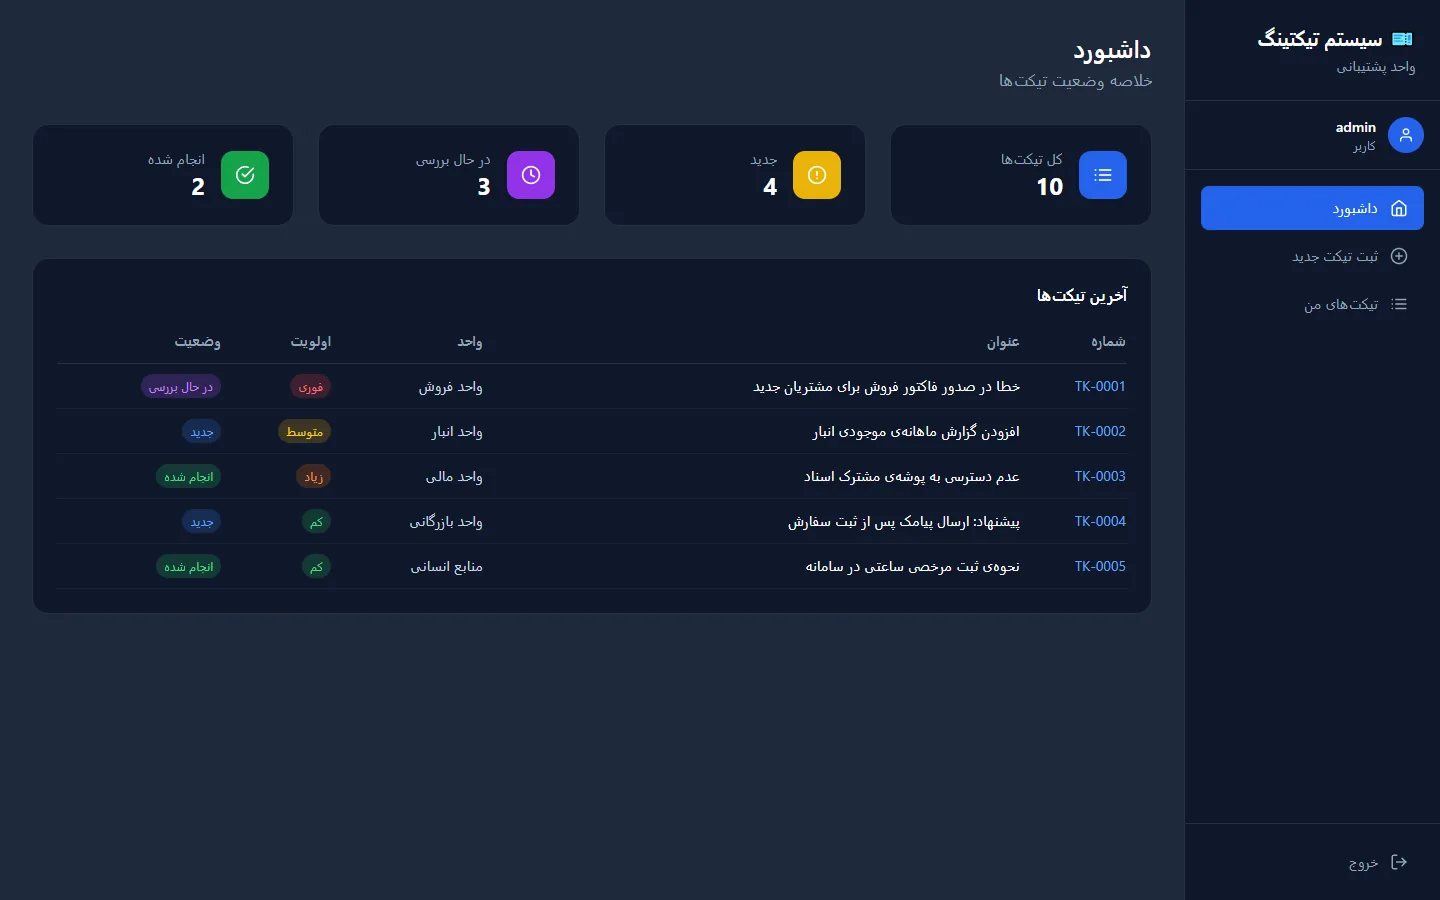
Ticketsystem für den internen Support
Erfassung und Nachverfolgung interner Support-Anfragen, mit Status-Workflow und rollenbasierten Rechten.
Projektdetails ansehenWenn Sie etwas Ähnliches brauchen oder eine Idee für individuelle Software haben, sprechen wir darüber.